
Moins de demandes abandonnées grâce à un parcours de financement simplifié
Client: Horyzont Capital
Secteur: FinTech
IA
Estimation du risque et des dommages, détection de fraudes, gestion des déclarations du premier contact jusqu'au versement. Où l'IA dans l'assurance produit un effet mesurable, ce que les textes permettent d'automatiser et quand il vaut mieux rester sur des règles et un gestionnaire de sinistres expérimenté.
Tomasz Kozon
CEO
16 août 2026
Lundi, huit heures et demie. Dans le système attendent plusieurs centaines de déclarations du week-end : accrochages sur des parkings, salles de bains inondées, vitres brisées, deux séjours à l'hôpital. La plupart sont simples et honnêtes, et pourtant chacune suit le même chemin. Le gestionnaire de sinistres ouvre les pièces jointes, recopie les données dans le système, regarde les photos, demande les documents manquants. Quelque part dans la pile se trouve un sinistre dont la photo avait déjà été jointe à une autre déclaration il y a six mois. Personne ne le remarquera, parce que personne n'a le temps de comparer. C'est précisément lors d'un tel lundi que l'on voit le mieux à quoi l'IA dans l'assurance sert vraiment.
Les domaines évoqués dans le titre ont plus en commun que ne le suggèrent les noms des services. L'estimation automatique (de la prime ou du dommage) consiste à prédire un montant à partir de données. La détection de fraudes revient à chercher les cas qui s'écartent du schéma. La gestion des sinistres est, pour une large part, la lecture de documents et la prise de décisions répétitives. Dans chacun de ces domaines, un modèle peut reprendre une partie du travail. Dans aucun, il ne devrait fonctionner sans supervision.
Nous décrivons ci-dessous à quoi cela ressemble du côté de la mise en œuvre : quelles données sont nécessaires, ce qu'il est permis d'automatiser au regard des textes polonais et européens, où les modèles se trompent et quand il vaut mieux rester sur des règles et un gestionnaire de sinistres expérimenté. Nous écrivons du point de vue d'une équipe qui conçoit des logiciels pour les sociétés d'assurance et les relie aux systèmes que ces sociétés exploitent déjà.
L'explication la plus simple tient aux chiffres. Selon le rapport de la Chambre polonaise de l'assurance (Polska Izba Ubezpieczeń, PIU) de juillet 2026, les assureurs ont révélé en 2025 des infractions d'une valeur totale de près de 800 millions de PLN, soit 18 % de plus qu'un an plus tôt (675 millions de PLN). En assurance de biens, environ 64 % des cas détectés concernaient l'automobile : collisions simulées, accidents provoqués intentionnellement, blessures fictives et vols de voitures mis en scène. Et ce n'est que ce qui a été porté au jour. Insurance Europe estime que les fraudes détectées et non détectées représentent ensemble environ 10 % de toutes les dépenses d'indemnisation en Europe. La technique même des fraudes a changé. Le même rapport de la PIU indique que les auteurs utilisent massivement des outils d'IA accessibles à tous pour fabriquer de la documentation médicale. Une fausse fiche de sortie d'hôpital ou une facture de réparation est produite en quelques minutes et paraît correcte. Le contrôle fondé sur le fait que le gestionnaire de sinistres « remarquera quelque chose de bizarre » cesse de suffire dès lors que le faux ne comporte ni fautes de frappe ni tampons de travers.
De l'autre côté se trouve le client, qui attend son argent. L'article 817 du Code civil polonais donne à l'assureur 30 jours à compter de la réception de la déclaration de sinistre et, lorsque les circonstances exigent un éclaircissement, 14 jours à compter du moment où, avec la diligence requise, elles pouvaient être élucidées. La partie non contestée de la prestation doit être versée dans le premier délai. Le client, lui, ne compare pas le service au code. Il le compare à sa banque, où un virement passe en quelques secondes.
Le secteur réagit déjà. Dans l'enquête de l'EIOPA, l'autorité européenne de surveillance des assurances, menée auprès de 209 compagnies de 22 pays et publiée en 2024, 50 % des assureurs de biens et 24 % des assureurs vie déclaraient utiliser l'IA. Un autre 30 % et 39 % prévoyaient une mise en œuvre dans les trois ans. Les usages les plus souvent cités sont le service client, la détection de fraudes, la gestion des sinistres, la vente et la tarification. Les données ont une réserve : elles décrivent la situation de 2022, avant la généralisation des modèles génératifs.
Client: Horyzont Capital
Secteur: FinTech
Client: Jabłoński & Wspólnicy
Secteur: LegalTech
Le mot « estimation » recouvre deux choses très différentes dans l'assurance. La première est l'estimation du risque, c'est-à-dire la fixation de la prime à la souscription du contrat. La seconde est l'estimation du dommage, c'est-à-dire la détermination de ce qui revient à la victime. Les deux peuvent être soutenues par des modèles, mais chacune exige des données différentes et porte un risque d'erreur différent.
Le tarif est en général un modèle statistique construit par des actuaires, le plus souvent un modèle linéaire généralisé (GLM). C'est une méthode classique dans laquelle chaque facteur, par exemple l'âge du véhicule ou le code postal, a un poids explicite et vérifiable. L'apprentissage automatique ne remplace pas ce tarif, il le complète. Les modèles d'ensemble, qui combinent les résultats de nombreux arbres de décision simples, comme le gradient boosting, repèrent d'eux-mêmes des dépendances que personne n'avait inscrites à l'avance dans le GLM. Un jeune conducteur dans une grande ville provoque d'autres sinistres qu'un jeune conducteur à la campagne, et la seule variable « âge » ne le montrera pas. En pratique, le modèle d'apprentissage automatique suggère le plus souvent aux actuaires dans quels segments le tarif se trompe, plutôt que de calculer lui-même la prime. La raison est simple. Il faut pouvoir justifier le tarif devant le superviseur et le client, et « c'est ce qui est sorti du modèle » n'est pas une justification.
Un effet plus important que le changement d'algorithme vient souvent de nouvelles sources de données. Pour l'assurance habitation, ce sont des données de localisation, par exemple la distance à une rivière et l'historique des inondations dans le secteur. Les modèles automatiques d'estimation immobilière, utilisés par le marché du crédit hypothécaire, fonctionnent sur un principe comparable. En assurance automobile, une telle source est la télématique, c'est-à-dire les données sur le style de conduite recueillies par une application ou un boîtier dans la voiture. Chaque nouvelle source soulève toutefois une question : le consentement du client et la possibilité d'utiliser ces données dans une décision automatique. Nous y revenons dans la partie consacrée aux textes.
En sinistres automobiles, le premier « expert » est de plus en plus souvent une application. Le client photographie la voiture en suivant les indications à l'écran, et la reconnaissance d'image par l'IA identifie les éléments endommagés et propose un périmètre de travaux, de la peinture au remplacement de pièces. Sur cette base, le système de chiffrage calcule un montant. Pour les dégâts de carrosserie classiques sur les modèles répandus, cela fonctionne bien. Cela fonctionne moins bien pour les dommages invisibles sur une photo, comme un support fissuré derrière le pare-chocs ou un capteur de radar endommagé. Un processus bien réglé traite donc l'estimation par photo comme une proposition. Le client peut l'accepter immédiatement et, au-dessus d'un certain montant ou si le modèle est peu sûr, l'affaire part en expertise. Un dégât des eaux ou un incendie, c'est une autre situation, car les photos parlent moins. La lecture des factures et des devis des artisans, puis la comparaison des prix avec l'historique de sinistres comparables dans la même région, apportent davantage. Le modèle évalue alors avant tout la vraisemblance des montants.
La détection de fraudes (fraud detection) ne consiste pas pour le modèle à « savoir » qui ment. Elle consiste à attribuer à chaque sinistre un score de risque et à orienter les cas les plus suspects vers des spécialistes. C'est une tâche classique de l'analyse prédictive. La décision de refus d'indemnisation pour soupçon de fraude doit revenir à un humain qui connaît le dossier.
La plupart des compagnies disposent déjà d'un système de règles, les red flags. Sinistre déclaré quelques jours après la souscription, collision de nuit sans témoins, montant de garantie relevé juste avant l'incendie, déclarant qui ne se souvient pas des détails de l'événement mais connaît parfaitement les conditions de la police. Les règles sont transparentes et faciles à expliquer. Elles ont en revanche deux défauts : elles génèrent beaucoup d'alertes et deviennent vite connues. Qui a déjà reçu un refus sait ce qu'il faut éviter la fois suivante. Un modèle d'apprentissage automatique regarde des centaines de caractéristiques à la fois et évalue leur combinaison. Il apprend sur des sinistres historiques dont la nature de fraude a été confirmée par le passé. Là se cache le premier piège. De tels cas sont peu nombreux, et ceux qui existent montrent surtout des schémas que l'équipe savait déjà détecter. C'est pourquoi, à côté des modèles entraînés sur des exemples, on recourt à la détection d'anomalies, c'est-à-dire à la recherche de sinistres atypiques sur l'ensemble du portefeuille, sans étiquette « fraude » préétablie.
Les bandes organisées apparaissent le plus souvent à la lumière lors de l'analyse des liens. Le même numéro de téléphone pour cinq sinistres. Le même atelier pour des collisions impliquant les mêmes conducteurs. Un témoin d'un accrochage devenu l'auteur d'un autre. Un sinistre isolé ne soulève pas de soupçons, le réseau entier, si. Techniquement, c'est un graphe dont les nœuds sont les personnes, les véhicules, les adresses et les ateliers, et les arêtes les sinistres partagés. De telles dépendances n'apparaissent qu'à partir du moment où les données du système de polices et du système de sinistres se retrouvent au même endroit.
L'IA agit ici des deux côtés. Les fraudeurs génèrent des documents et retouchent des photos, l'assureur emploie des techniques voisines pour les détecter. Des tests simples apportent beaucoup : vérifier que la même photo, ou une photo très ressemblante, n'est pas déjà apparue dans un autre sinistre, et que les métadonnées du fichier, par exemple la date de prise de vue et les coordonnées, coïncident avec la description de l'événement. Les documents sont comparés aux modèles que tel établissement de santé ou tel atelier ont émis auparavant. Détecter des contenus entièrement générés par l'IA est plus difficile. C'est une course dans laquelle le détecteur reste le plus souvent un pas derrière le générateur, comme pour les images et enregistrements de type deepfake. Une vérification à la source se révèle souvent plus efficace : interroger l'hôpital pour savoir s'il a bien émis tel document, ou comparer les données avec les registres auxquels l'assureur a accès.
Chaque sinistre marqué comme suspect a un coût. Le temps du spécialiste et la patience du client, qui le plus souvent se révèle honnête, et dont l'argent se fait attendre plus longtemps. Un modèle qui détecte davantage de fraudes au prix d'un doublement du nombre d'alertes peut en pratique dégrader le résultat, car l'équipe d'enquête ne viendra pas à bout de la file. Le seuil d'alerte se règle donc en fonction de la capacité de l'équipe et de la valeur des sinistres. Une « efficacité » abstraite du modèle ne dit pas grand-chose ici. L'indicateur le plus simple à suivre est la part des alertes qui aboutissent à la mise au jour effective d'une fraude. Lorsqu'elle baisse, le modèle ou les règles demandent un réexamen.
La gestion d'un sinistre, c'est-à-dire tout le processus de la déclaration au versement, est pour une large part un travail sur documents et des échanges avec le client. C'est là que l'IA se rentabilise le plus vite, car l'effet se voit immédiatement sur le temps de traitement.
Les déclarations sont parfois chaotiques. Le client écrit un courriel sans numéro de police, et envoie les photos dans trois messages séparés. Un chatbot qui reçoit les déclarations de sinistres relance pour les données manquantes, vérifie la police, reconnaît le type de sinistre et indique d'emblée quels documents seront nécessaires. Lorsque l'affaire sort de son périmètre, il passe la main à un conseiller en lui transmettant ce qu'il a déjà établi. Une partie des clients préfère téléphoner, surtout juste après l'accident. En période de forte affluence sur la ligne d'assistance, le même travail est effectué par des voicebots, qui recueillent les informations de base et ouvrent le dossier. Un échange avec une personne en état de choc ou après un accident grave gagne toutefois à être transféré immédiatement à un humain.
Factures, devis, fiches de sortie d'hôpital, procès-verbaux de police, constats amiables. L'OCR classique, c'est-à-dire la conversion du scan en texte, n'est qu'un début. Un modèle de langage, c'est-à-dire le même type d'IA sur lequel reposent les chats de type ChatGPT, comprend ce qui est quoi. Il sait que le montant en bas de la facture est la valeur TTC, que le diagnostic sur la fiche d'hôpital a été noté avec un code ICD-10, que la date du tampon diffère de la date de l'événement et que, dans le constat, le responsable reconnaît sa faute. Il en ressort des données structurées, qui vont directement dans le système de sinistres.
La documentation médicale constitue une catégorie particulière de données au sens du RGPD, c'est-à-dire notamment les informations sur la santé. Le choix du modèle et du lieu de traitement relève alors à parts égales du juriste et de l'architecte du système. L'application elle-même, par laquelle transitent de telles données, gagne à être soumise à un audit de sécurité applicative avant la mise en production.
Une partie des sinistres n'a pas du tout besoin d'un gestionnaire. Un bris de glace ou le remboursement d'une consultation médicale dans la limite d'un plafond sont de bons exemples. Lorsque le montant est bas, les conditions claires, les documents complets et l'évaluation du risque de fraude faible, le système peut préparer la décision et le versement sans intervention humaine. Un tel partage des affaires, appelé triage, fait que les gestionnaires s'occupent des sinistres où leur expérience a de la valeur. Le seuil de versement automatique gagne à être placé bas au démarrage. On le relève lorsque les données de quelques mois montrent que les décisions de l'automate ne s'écartent pas de celles des humains.
Les conditions générales d'assurance (CGA) peuvent compter plusieurs dizaines de pages, et plusieurs versions coexistent dans le portefeuille. Un assistant construit avec la technique RAG, c'est-à-dire un modèle de langage qui répond à partir de documents désignés et non de sa propre mémoire, retrouve la clause pertinente et affiche le paragraphe d'où elle provient. Le gestionnaire reste décideur. Simplement, il ne perd plus une demi-heure à chercher une exclusion de garantie.
Le même assistant aide à rédiger les motivations de décisions et les réponses aux réclamations. À une condition : chaque texte qui part au client est lu et validé par un humain. Les modèles de langage ont l'air sûrs d'eux même quand ils se trompent.
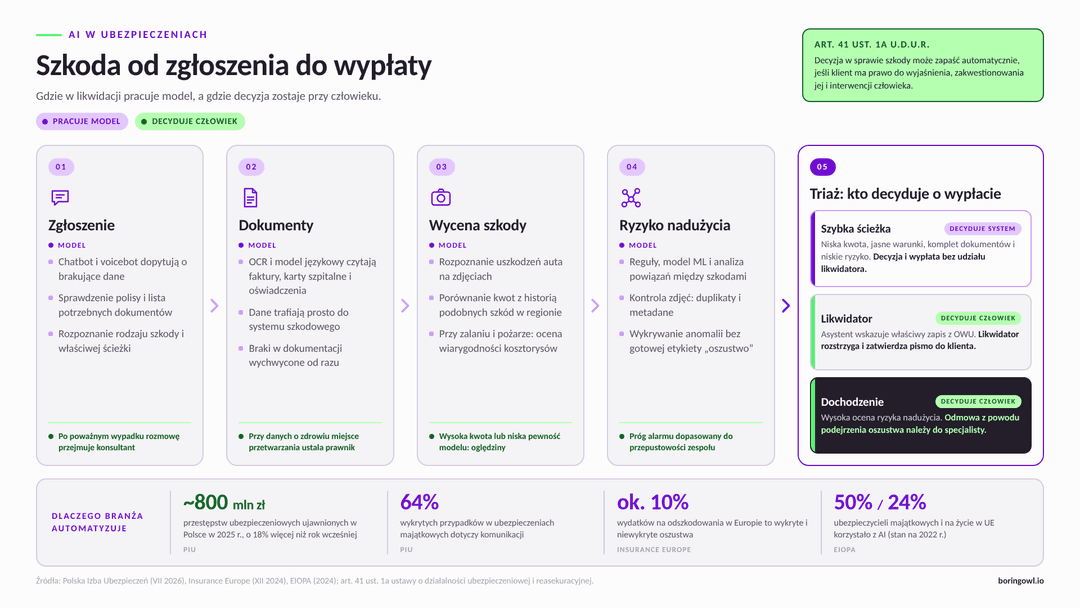
Le point de départ est l'article 22 du RGPD. Il donne à chacun le droit de ne pas être soumis à une décision fondée exclusivement sur un traitement automatisé, lorsqu'elle produit à son égard des effets juridiques ou l'affecte de manière significative de façon analogue. Le législateur polonais a prévu pour l'assurance une base distincte. L'article 41, alinéa 1a de la loi sur l'activité d'assurance et de réassurance permet à une compagnie d'assurance de prendre de telles décisions pour l'évaluation du risque d'assurance ainsi que pour l'établissement des causes des événements et du montant des dommages. Condition : le client conserve le droit de recevoir des explications sur les motifs de la décision, de la contester, de présenter son propre point de vue et d'obtenir une intervention humaine.
Il en découle des exigences concrètes pour le système. Le modèle doit laisser une trace des données et des facteurs sur la base desquels il a pris la décision, car sans cela on ne peut l'expliquer. Le processus doit prévoir une voie de recours auprès d'un humain. Pour les décisions automatisées, seules les catégories de données énumérées à l'alinéa 1b de cet article peuvent être utilisées, de sorte que l'approche « mettons dans le modèle tout ce que nous avons » est exclue.
L'AI Act, le règlement européen sur l'intelligence artificielle, classe parmi les systèmes à haut risque ceux utilisés pour l'évaluation du risque et la tarification en assurance vie et santé des personnes physiques (annexe III, point 5, lettre c). Les assurances automobiles et de biens, ainsi que la détection de fraudes, ne figurent pas sur cette liste. L'échéance d'application des obligations pour les systèmes de l'annexe III a été repoussée par le règlement (UE) 2026/1744, dit Digital Omnibus, entré en vigueur le 27 juillet 2026. Au lieu d'août 2026, elles s'appliquent à partir du 2 décembre 2027. Il s'agit notamment du système de gestion des risques, de la documentation technique, de l'enregistrement des événements et de la supervision humaine.
Le fait que le système n'entre pas dans la catégorie à haut risque ne dispense pas de responsabilités. L'EIOPA, dans un avis d'août 2025, a décrit ce que la supervision attend pour les autres usages de l'IA dans l'assurance : une gouvernance des données documentée, la vérification que les résultats ne sont pas discriminatoires, l'explicabilité et une supervision humaine réelle.
Tout problème au service sinistres n'est pas un problème pour un modèle. La mise en œuvre ne se défend généralement pas dans cinq situations :
La situation inverse se produit aussi. Les règles fonctionnent bien, et l'entreprise veut « ajouter de l'IA » parce que la concurrence le fait. La recommandation la plus honnête est alors d'améliorer les règles et le reporting. Moins spectaculaire. Mais moins cher.
FAQ
Blog
L'évolution du service client prend aujourd'hui la forme de processus de plus en plus avancés. Les voicebots y jouent un rôle clé en apportant une dimension innovante à l'automatisation en entreprise. Ils fluidifient la communication et font gagner un temps précieux, devenant un élément incontournable des entreprises modernes.
L'Agentic Commerce Protocol (ACP) d'OpenAI et Stripe décrit comment un agent IA passe une commande dans une boutique en ligne au nom du client. Nous le décomposons en six notions — du flux produits au webhook de commande — et examinons ce que la première mise en œuvre dans ChatGPT implique pour une boutique en Pologne.
La mise en œuvre de l'IA dans une entreprise commence rarement par l'achat d'un gros système. Nous la présentons comme cinq paliers — depuis des règles pour les outils que les collaborateurs utilisent déjà jusqu'à l'IA au cœur de votre propre produit — et nous indiquons comment choisir le premier processus et à quoi reconnaître qu'un pilote a été rentable.
L'intelligence artificielle dans le service client a parcouru le chemin qui va des bots à boutons aux agents IA qui règlent eux-mêmes les demandes dans les systèmes de l'entreprise. Nous montrons, sur une seule question du client, comment répondent quatre générations de bots, quand un humain est nécessaire, comment mesurer les effets et par où commencer la mise en œuvre.
L'intelligence artificielle dans l'hôtellerie, c'est aujourd'hui un ensemble d'outils concrets à chaque étape du parcours du client, des questions avant la réservation aux avis après le départ. Nous les classons en trois groupes : ce qui rentabilise déjà, ce qui demande une préparation et ce qui n'est pour l'instant qu'une promesse.
L'IA dans la finance prend de plus en plus souvent la première décision à la place de l'humain — pour évaluer la solvabilité, détecter les fraudes ou qualifier les demandes. Nous expliquons comment fonctionnent ces systèmes, quelles données ils utilisent et où se trouvent les vraies difficultés de mise en œuvre.