

Moins de demandes abandonnées grâce à un parcours de financement simplifié
Client: Horyzont Capital
Secteur: FinTech
IA
L'IA dans la finance prend de plus en plus souvent la première décision à la place de l'humain — pour évaluer la solvabilité, détecter les fraudes ou qualifier les demandes. Nous expliquons comment fonctionnent ces systèmes, quelles données ils utilisent et où se trouvent les vraies difficultés de mise en œuvre.
Tomasz Kozon
CEO
23 sept. 2026
L'IA dans la finance n'est plus seulement un outil d'analyse de données a posteriori. Elle prend de plus en plus souvent la première décision — accorder ou non un crédit, savoir si une transaction paraît suspecte, si la demande d'un client est éligible à la suite du traitement. L'humain supervise toujours le processus, mais c'est le modèle qui évalue le dossier en une fraction de seconde, avant que quiconque ne s'y penche. Pour une banque, un fonds ou une société de crédit, cela représente un changement opérationnel concret. Une demande qui attendait autrefois son tour dans la file d'un analyste reçoit aujourd'hui une évaluation préliminaire immédiate. L'équipe s'occupe des exceptions et des cas limites, et non plus de chaque demande une par une. Cela déplace le travail humain de la routine vers les décisions qui exigent réellement de l'expérience.
Il convient d'emblée de distinguer deux niveaux d'automatisation, car on les confond souvent dans les discussions. Le premier est l'aide à la décision — le modèle calcule un score, un risque ou une recommandation, mais le dernier mot revient toujours à l'humain. Le second est la décision entièrement automatique — le système accepte ou rejette lui-même la demande, sans intervention d'un analyste, dans le cadre de règles définies à l'avance.
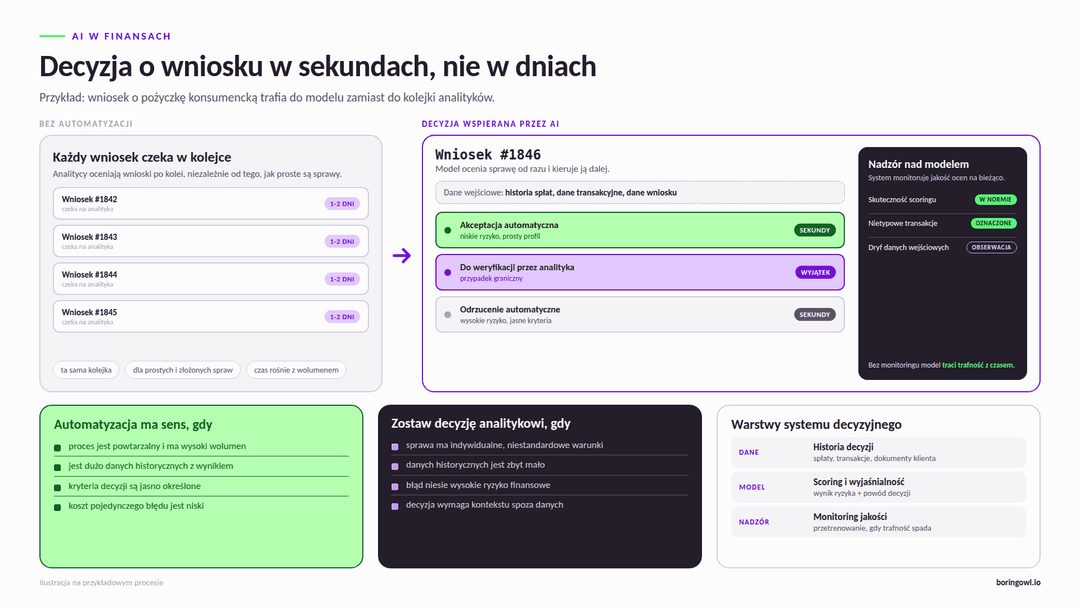
En pratique, la plupart des institutions commencent par le premier niveau et évoluent progressivement vers le second, là où le risque d'erreur est faible et le volume élevé. Un petit crédit à la consommation avec un profil client standardisé se prête plus vite à une automatisation complète qu'un gros crédit entreprise aux conditions sur mesure. Ce dernier reste généralement sur le modèle d'assistance, où l'IA prépare l'analyse et où la décision est prise par un comité de crédit. La frontière entre ces deux niveaux ne tient pas tant à la technologie elle-même qu'à l'appétit au risque de l'institution et à la qualité des données sur lesquelles le modèle a appris. Plus les cas historiques avec un résultat clair sont nombreux — crédit remboursé ou non, transaction frauduleuse ou non — plus il est facile de confier au modèle une décision entièrement automatique.
La manière dont une organisation parvient à de telles règles est un sujet à part entière, que nous avons décrit plus largement à propos du processus décisionnel en IT — là où la décision porte sur le choix d'une technologie, le mécanisme d'attribution des responsabilités est très proche de celui qui accompagne la mise en œuvre d'une automatisation.
L'usage le plus mature de l'IA dans la finance, c'est l'évaluation de la solvabilité. Au lieu d'un indicateur unique calculé une seule fois à l'entrée, le scoring moderne combine des données issues de nombreuses sources — historique de remboursements, données transactionnelles du compte, parfois aussi données comportementales, comme la manière de remplir le formulaire. Le modèle recourt aux techniques d'apprentissage automatique et s'entraîne sur des milliers de décisions antérieures, à la recherche de schémas difficiles à repérer dans une grille de points traditionnelle. Le mécanisme est bien illustré par l'arbre de décision — l'une des méthodes d'apprentissage automatique les plus simples mais encore utilisées, dans laquelle le modèle divise les données selon des critères successifs, jusqu'à aboutir à une recommandation précise. En pratique, les banques s'appuient rarement sur un seul modèle de ce type ; elles combinent les résultats de plusieurs approches, des arbres les plus simples aux réseaux plus complexes, et tiennent compte de leur convergence.
L'effet pour le client est mesurable. Une demande de crédit qui attendait autrefois un ou deux jours chez un analyste reçoit aujourd'hui une décision préliminaire en quelques secondes. Cela ne signifie pas que chaque demande est acceptée automatiquement — les cas limites sont tout de même remontés à un humain, mais leur nombre est bien inférieur à celui d'une analyse entièrement manuelle.
À côté du scoring, l'usage le plus fréquent est la détection de fraudes (fraud detection) — repérer les transactions qui s'écartent du comportement habituel du client. Le modèle apprend le profil de chaque compte : combien il dépense habituellement, où, à quelle heure, par quels canaux. Une transaction qui ne correspond pas à ce schéma reçoit un score de risque plus élevé et passe par une vérification supplémentaire avant d'être validée. La différence avec les anciens systèmes de règles métier — du type « bloquer toute transaction supérieure à cinq mille euros à l'étranger » — est fondamentale. La règle est rigide et facile à contourner dès que le fraudeur la connaît. Un modèle qui apprend en continu s'adapte à de nouveaux schémas de fraude, à condition toutefois d'être alimenté en permanence de données fraîches et d'être régulièrement réentraîné.
Une logique similaire, mais dans un autre secteur, a été décrite à propos de l'IA dans l'assurance, où les modèles évaluent les déclarations de sinistres sous l'angle de la probabilité d'abus. Le mécanisme est proche — dans les deux cas, il s'agit de distinguer un comportement normal d'un écart qui mérite l'attention d'un humain.
Avant qu'une demande n'arrive à l'évaluation du risque, quelqu'un — ou quelque chose — doit vérifier si elle est seulement complète et correcte. C'est une tâche qui se prête bien à l'automatisation, car elle est répétitive et dotée de critères clairs : document manquant, incohérence de données, limite d'âge dépassée. Les grands modèles de langage savent lire les documents transmis par le client, en extraire les données nécessaires et vérifier leur cohérence avec la demande déposée, au lieu de mobiliser un collaborateur à chaque étape. Seule la demande qui a passé cette qualification initiale rejoint ensuite l'évaluation du risque proprement dite. Une telle approche s'inscrit bien dans une architecture fondée sur LangChain, framework qui relie les modèles de langage à des sources de données externes et aux documents du client.
La qualification initiale ne s'arrête pas aux documents. De plus en plus souvent, elle couvre aussi le premier contact avec le client — un chatbot ou un voicebot recueille les informations de base sur le besoin financier avant que le dossier n'arrive au conseiller, qui ne traite plus que les cas nécessitant un échange.
Il convient de distinguer cela de l'automatisation robotisée des processus, plus simple, qui recopie des données d'un système à l'autre selon des règles rigides, sans porter de jugement. Les deux approches coexistent souvent — le RPA décharge les collaborateurs des tâches mécaniques, et les modèles IA s'occupent de ce qui demande une véritable appréciation de la situation.
Client: Horyzont Capital
Secteur: FinTech
Au-delà des décisions concernant un client individuel, l'IA dans la finance soutient aussi les décisions à l'échelle de l'institution tout entière — évaluation du risque du portefeuille de crédits, prévision des pertes, détection de signaux d'alerte dans les données opérationnelles. Ce domaine relève davantage de l'analytique que de l'automatisation d'une transaction isolée, mais il repose sur les mêmes fondations : des données de bonne qualité et des modèles régulièrement vérifiés.
Nous abordons le contexte plus large de ce sujet dans l'article consacré au risque opérationnel — les menaces liées aux défaillances des systèmes, des processus ou des personnes, qui, dans une institution financière, se répercutent directement sur le résultat financier. Les modèles prédictifs aident à détecter de tels signaux plus tôt, avant qu'ils ne prennent l'ampleur d'un problème réel.
Construire un système qui automatise les décisions financières commence par les données — les collecter, les nettoyer et les réunir en une vue cohérente du client ou de la transaction. Les données proviennent généralement de plusieurs endroits à la fois : système bancaire, historique des transactions, parfois bases externes auxquelles l'institution a accès. Avant d'arriver au modèle, elles doivent passer par une couche de normalisation qui uniformise les formats et élimine les erreurs.
Le modèle lui-même est en général la plus petite partie du projet, même si c'est la plus visible. Ce qui l'entoure est plus important — la surveillance de la qualité des prédictions, le versionnage des modèles et la possibilité de retracer pourquoi telle décision est tombée ainsi et pas autrement. Dans la finance, l'explicabilité des décisions a une portée pratique, et pas seulement formelle : un analyste qui reçoit un refus de demande sans motif n'est pas en mesure de juger si le modèle se trompe.
Pour stocker et interroger de grands ensembles de données — par exemple des descriptions historiques de transactions ou des documents clients — les bases vectorielles comme Qdrant se prêtent bien à la tâche : elles permettent de retrouver rapidement des cas similaires du passé et de les utiliser comme contexte pour le modèle qui prend la décision du moment.
Les modèles de langage eux-mêmes, par exemple la famille Anthropic, rejoignent de plus en plus souvent cette pile comme couche qui relie les données non structurées — documents, descriptions, correspondance — au reste du système.
L'intégration avec les systèmes sources est généralement la partie la plus chronophage du projet, car les institutions financières ont rarement un seul système cohérent — plus souvent plusieurs, ajoutés au fil des années. Une architecture SaaS bien conçue facilite ce raccordement, mais élimine rarement le besoin d'écrire des connecteurs dédiés pour certains systèmes legacy.
Là où l'automatisation couvre aussi les processus opérationnels internes de l'institution, par exemple les rapprochements ou le reporting, un système dédié de type ERP se prête bien à la tâche : il devient la source unique de vérité pour les données qui alimentent le modèle.
Le plus gros problème n'est que rarement le modèle lui-même. C'est la qualité et la disponibilité des données historiques sur lesquelles on peut l'entraîner. Une institution qui a pris ses décisions à la main pendant des années sans consigner les motivations dispose de peu de matière pour entraîner un modèle — elle doit commencer par collecter des données avant que l'automatisation ne devienne possible.
Le deuxième défi est de maintenir le modèle dans le temps. Les comportements des clients et les schémas de fraude évoluent, si bien qu'un modèle entraîné il y a un an peut prendre aujourd'hui de moins bonnes décisions qu'au démarrage. Cela exige une surveillance continue de la qualité des prédictions et un processus qui signale la baisse d'efficacité avant que les clients ou l'audit interne ne la remarquent.
Le troisième problème, plus souvent négligé, est la sécurité des systèmes décisionnels eux-mêmes. Un modèle qui accepte automatiquement des demandes de crédit est une cible attrayante — une faille dans ses protections peut coûter plus cher qu'une erreur dans l'évaluation du risque elle-même. C'est pourquoi les projets de ce type gagnent à être menés dès le départ avec un audit de sécurité applicative, du type de celui décrit dans nos services de sécurité.
L'automatisation totale de toutes les décisions d'un coup est un mauvais point de départ. Il vaut mieux choisir un seul processus à fort volume et à risque unitaire relativement faible — par exemple la qualification initiale de demandes simples — et bâtir pour lui un système opérationnel, avant d'étendre le périmètre à des décisions plus complexes.
Il est utile de commencer par un atelier qui précise quelles décisions se prêtent à l'automatisation et lesquelles valent mieux laisser à l'humain — un travail proche de ce que nous faisons dans le cadre du product discovery. C'est seulement sur cette base que l'on peut planifier sérieusement l'architecture des données et choisir quels éléments construire de zéro et lesquels appuyer sur des composants prêts à l'emploi.
Un projet de ce type s'achève rarement par une seule mise en œuvre. Le modèle demande de la maintenance, les données s'accumulent, et le périmètre d'automatisation s'élargit généralement à mesure que la confiance dans le système grandit — c'est l'une des raisons pour lesquelles nous le traitons comme une composante d'une transformation digitale plus large de l'institution, et non comme un projet technologique isolé.
Si votre institution envisage d'automatiser l'un de ses processus décisionnels, décrivez-nous votre projet via le formulaire de contact de Boring Owl.
FAQ
Blog
Estimation du risque et des dommages, détection de fraudes, gestion des déclarations du premier contact jusqu'au versement. Où l'IA dans l'assurance produit un effet mesurable, ce que les textes permettent d'automatiser et quand il vaut mieux rester sur des règles et un gestionnaire de sinistres expérimenté.
L'Agentic Commerce Protocol (ACP) d'OpenAI et Stripe décrit comment un agent IA passe une commande dans une boutique en ligne au nom du client. Nous le décomposons en six notions — du flux produits au webhook de commande — et examinons ce que la première mise en œuvre dans ChatGPT implique pour une boutique en Pologne.
La mise en œuvre de l'IA dans une entreprise commence rarement par l'achat d'un gros système. Nous la présentons comme cinq paliers — depuis des règles pour les outils que les collaborateurs utilisent déjà jusqu'à l'IA au cœur de votre propre produit — et nous indiquons comment choisir le premier processus et à quoi reconnaître qu'un pilote a été rentable.
L'intelligence artificielle dans le service client a parcouru le chemin qui va des bots à boutons aux agents IA qui règlent eux-mêmes les demandes dans les systèmes de l'entreprise. Nous montrons, sur une seule question du client, comment répondent quatre générations de bots, quand un humain est nécessaire, comment mesurer les effets et par où commencer la mise en œuvre.
L'intelligence artificielle dans l'hôtellerie, c'est aujourd'hui un ensemble d'outils concrets à chaque étape du parcours du client, des questions avant la réservation aux avis après le départ. Nous les classons en trois groupes : ce qui rentabilise déjà, ce qui demande une préparation et ce qui n'est pour l'instant qu'une promesse.
Personnalisation de l'apprentissage, e-learning adaptatif et tuteurs IA — l'intelligence artificielle dans l'éducation sort du stade pilote. Nous examinons ce qui fonctionne déjà aujourd'hui et par où commencer lorsque vous souhaitez mettre en œuvre l'IA dans les formations de votre entreprise.